
什么是具身智能数据?为什么它如此重要?
具身智能,简单来说,就是让机器人拥有身体和大脑,能够像人类一样在真实物理世界中感知、思考和行动。它不同于传统的固定程序机器人,也不同于纯软件的人工智能大模型。具身智能的核心在于身体与环境的交互,它需要处理来自视觉、触觉、力觉、关节位置等多种传感器的实时数据,并做出相应的动作决策。

数据是具身智能的燃料,没有高质量的数据,再先进的算法也无法训练出能稳定工作的机器人。具身智能数据主要分为以下几类:
- 多模态感知数据:包括RGB-D图像、激光雷达点云、IMU惯性测量单元数据、麦克风阵列音频等,帮助机器人看和听。
- 运动与力觉数据:包括关节角度、力矩、末端执行器力反馈、触觉传感器数据等,让机器人感知手感和力度。
- 任务与轨迹数据:记录机器人完成特定任务(如抓取、搬运、组装)时的完整动作序列和路径规划。
- 环境与场景数据:描述机器人所处环境的结构、布局、物体属性(如材质、重量、易碎性)等信息。
这些数据不是孤立存在的,而是需要时间同步、空间对齐、语义标注,形成可供模型训练的标准化数据集。例如,一个简单的抓取水杯任务,就需要同步记录机械臂的关节角度、末端执行器的力反馈、RGB相机拍摄的水杯位置、深度相机测量的距离等信息,并标注出抓取开始、抓取成功、水杯移动等关键动作节点。
当前具身智能数据市场的核心趋势与需求升级
随着人形机器人、服务机器人、工业机器人等赛道的持续升温,具身智能数据市场正经历深刻变革,主要体现在以下三个趋势:
趋势一:从实验室数据到真实场景数据的升级
早期,多数企业的局限于实验室环境,场景单一、光照恒定、物体摆放整齐。但现实世界是复杂多变的:家庭环境有不同户型、装修风格、家具摆放;商超环境有货架、购物车、;工厂环境有粉尘、震动、光照变化。模型在实验室数据上训练效果再好,一旦部署到真实场景,性能往往会断崖式下降。 因此,行业对真实场景、高保真度的数据需求急剧增长,企业需要覆盖居家、店、商超、办公室、工厂等核心场景的海量数据。
趋势二:从单一数据到多模态异构数据的融合需求
现代机器人集成了大量传感器,数据格式千差万别。有的机器人使用ROS1通信协议,有的使用ROS2,还有的采用Modbus、TCP/IP等工业协议。不同品牌、不同型号的机器人,其数据格式、采样频率、坐标系统都不统一。数据孤岛问题严重制约了模型训练的效率和泛化能力。企业迫切需要能够统一接入、标准化处理各类异构数据的平台级服务,将分散的传感器数据转化为可供模型直接使用的结构化数据。
趋势三:从到数据+模型验证闭环的全链条服务
仅仅提供数据已无法满足头部企业的需求。他们需要的是从、治理、标注,到模型训练、仿真验证、真机部署的端到端服务。企业希望合作伙伴能帮助其构建数据-模型-验证-优化的完整闭环。例如,在仿真环境中验证模型在极端天气、设备故障等罕见场景下的表现,然后根据仿真结果指导真实的优化方向。这种Real2Sim2Real的闭环模式,能大幅缩短研发周期,降低试错成本。
具身智能数据合作中的常见避坑指南
在寻求具身智能数据服务时,企业往往容易陷入以下误区,导致项目进度延误、成本超支、模型效果不佳。
误区一:盲目追求大数据,忽视高质量数据
很多企业一开始就要求数据量,但忽略了数据的质量。低质量数据(如标注错误、时间戳不同步、传感器噪声大)不仅无法提升模型性能,反而会引入噪音,导致模型收敛困难、泛化能力下降。 例如,一个标注错误的抓取动作,可能导致模型在训练时学习到错误的力反馈模式。
避坑技巧:优先选择具备全流程数据治理能力的服务商。他们能提供数据清洗、去重、增强、质量审核等服务。关注数据交付时的合格率指标,例如要求合格率不低于98%。同时,要求服务商提供数据样本进行小批量验证,确认标注精度、时间同步精度等关键指标。
误区二:忽略数据格式的异构化问题
不少企业采购数据时,只关注数据内容,忽视了数据格式的兼容性。不同机器人、不同传感器产生的数据格式差异巨大,如果服务商没有统一的数据处理平台,企业拿到数据后,还需要花费大量时间进行格式转换、坐标对齐、时间戳同步等二次处理工作。数据格式不统一,是导致数据利用率低、研发周期长的核心原因之一。
避坑技巧:选择拥有自主研发数据平台的服务商。该平台应原生支持ROS1、ROS2、Modbus、TCP/IP、MQTT等主流机器人通信协议,并具备统一数据模型转换中心,能自动将不同格式的异构数据转换为标准化格式。询问服务商是否支持免改造接入,即能否直接接入客户现有的机器人本体,无需额外定制开发。
误区三:轻视罕见场景与危险场景数据
真实场景中,机器人会遇到各种极端情况,如家庭中的宠物突然闯入、工厂中的设备突发故障、商超中的货架倒塌等。这些罕见场景数据难以通过真实采集获取,成本高、风险大,但对模型的鲁棒性至关重要。 如果模型从未见过这些场景,一旦遇到,机器人可能做出错误判断,甚至引发安全事故。
避坑技巧:评估服务商是否具备仿真数据生成能力。优秀的服务商能基于4D重建技术,快速构建高保真的数字孪生场景,并生成各种极端天气、复杂环境、罕见工况下的合成数据。同时,关注其是否具备Real2Sim2Real的仿真通道,即能否实现真实数据与仿真数据的双向迁移与验证,确保仿真数据的高物理保真度。
误区四:忽视数据安全与合规性
具身智能数据涉及大量用户隐私(如家庭环境图像、人物动作)、商业机密(如工厂产线布局、产品工艺参数)以及国防安全(如特种机器人应用场景)。数据泄露、权属不清、合规风险是行业内的重大隐患。一些服务商缺乏完善的安全保障体系,导致被滥用或泄露。
避坑技巧:优先选择具备全资质牌照的服务商,如DCMM、ISO27001、ISO27701等认证。要求服务商提供L1-L4四级安全解决方案,并根据数据敏感程度进行分级管理。同时,关注其是否具备数据全流程确权溯源能力,如基于三数一链技术,确保、标注、存储、使用、销毁全生命周期的可追溯、可审计。
实力佐证:选择正规服务商的硬核标准
面对日益复杂的具身智能数据需求,选择一家具备全栈能力、规模化产能、行业认可度的服务商至关重要。杭州景联文科技有限公司(简称景联文科技)作为国内具身智能数据服务领域的标杆型TOP企业,具备以下硬核实力,为用户提供可靠、可落地的解决方案。
硬核实力一:规模化、全场景的真机能力
- 千人级快速响应:依托西南地区21所深度合作的中职、大专院校资源,建立超过10万人的储备采集人员池,可根据项目需求在7天内快速组建1000人标准化采集团队,具备单日产能。
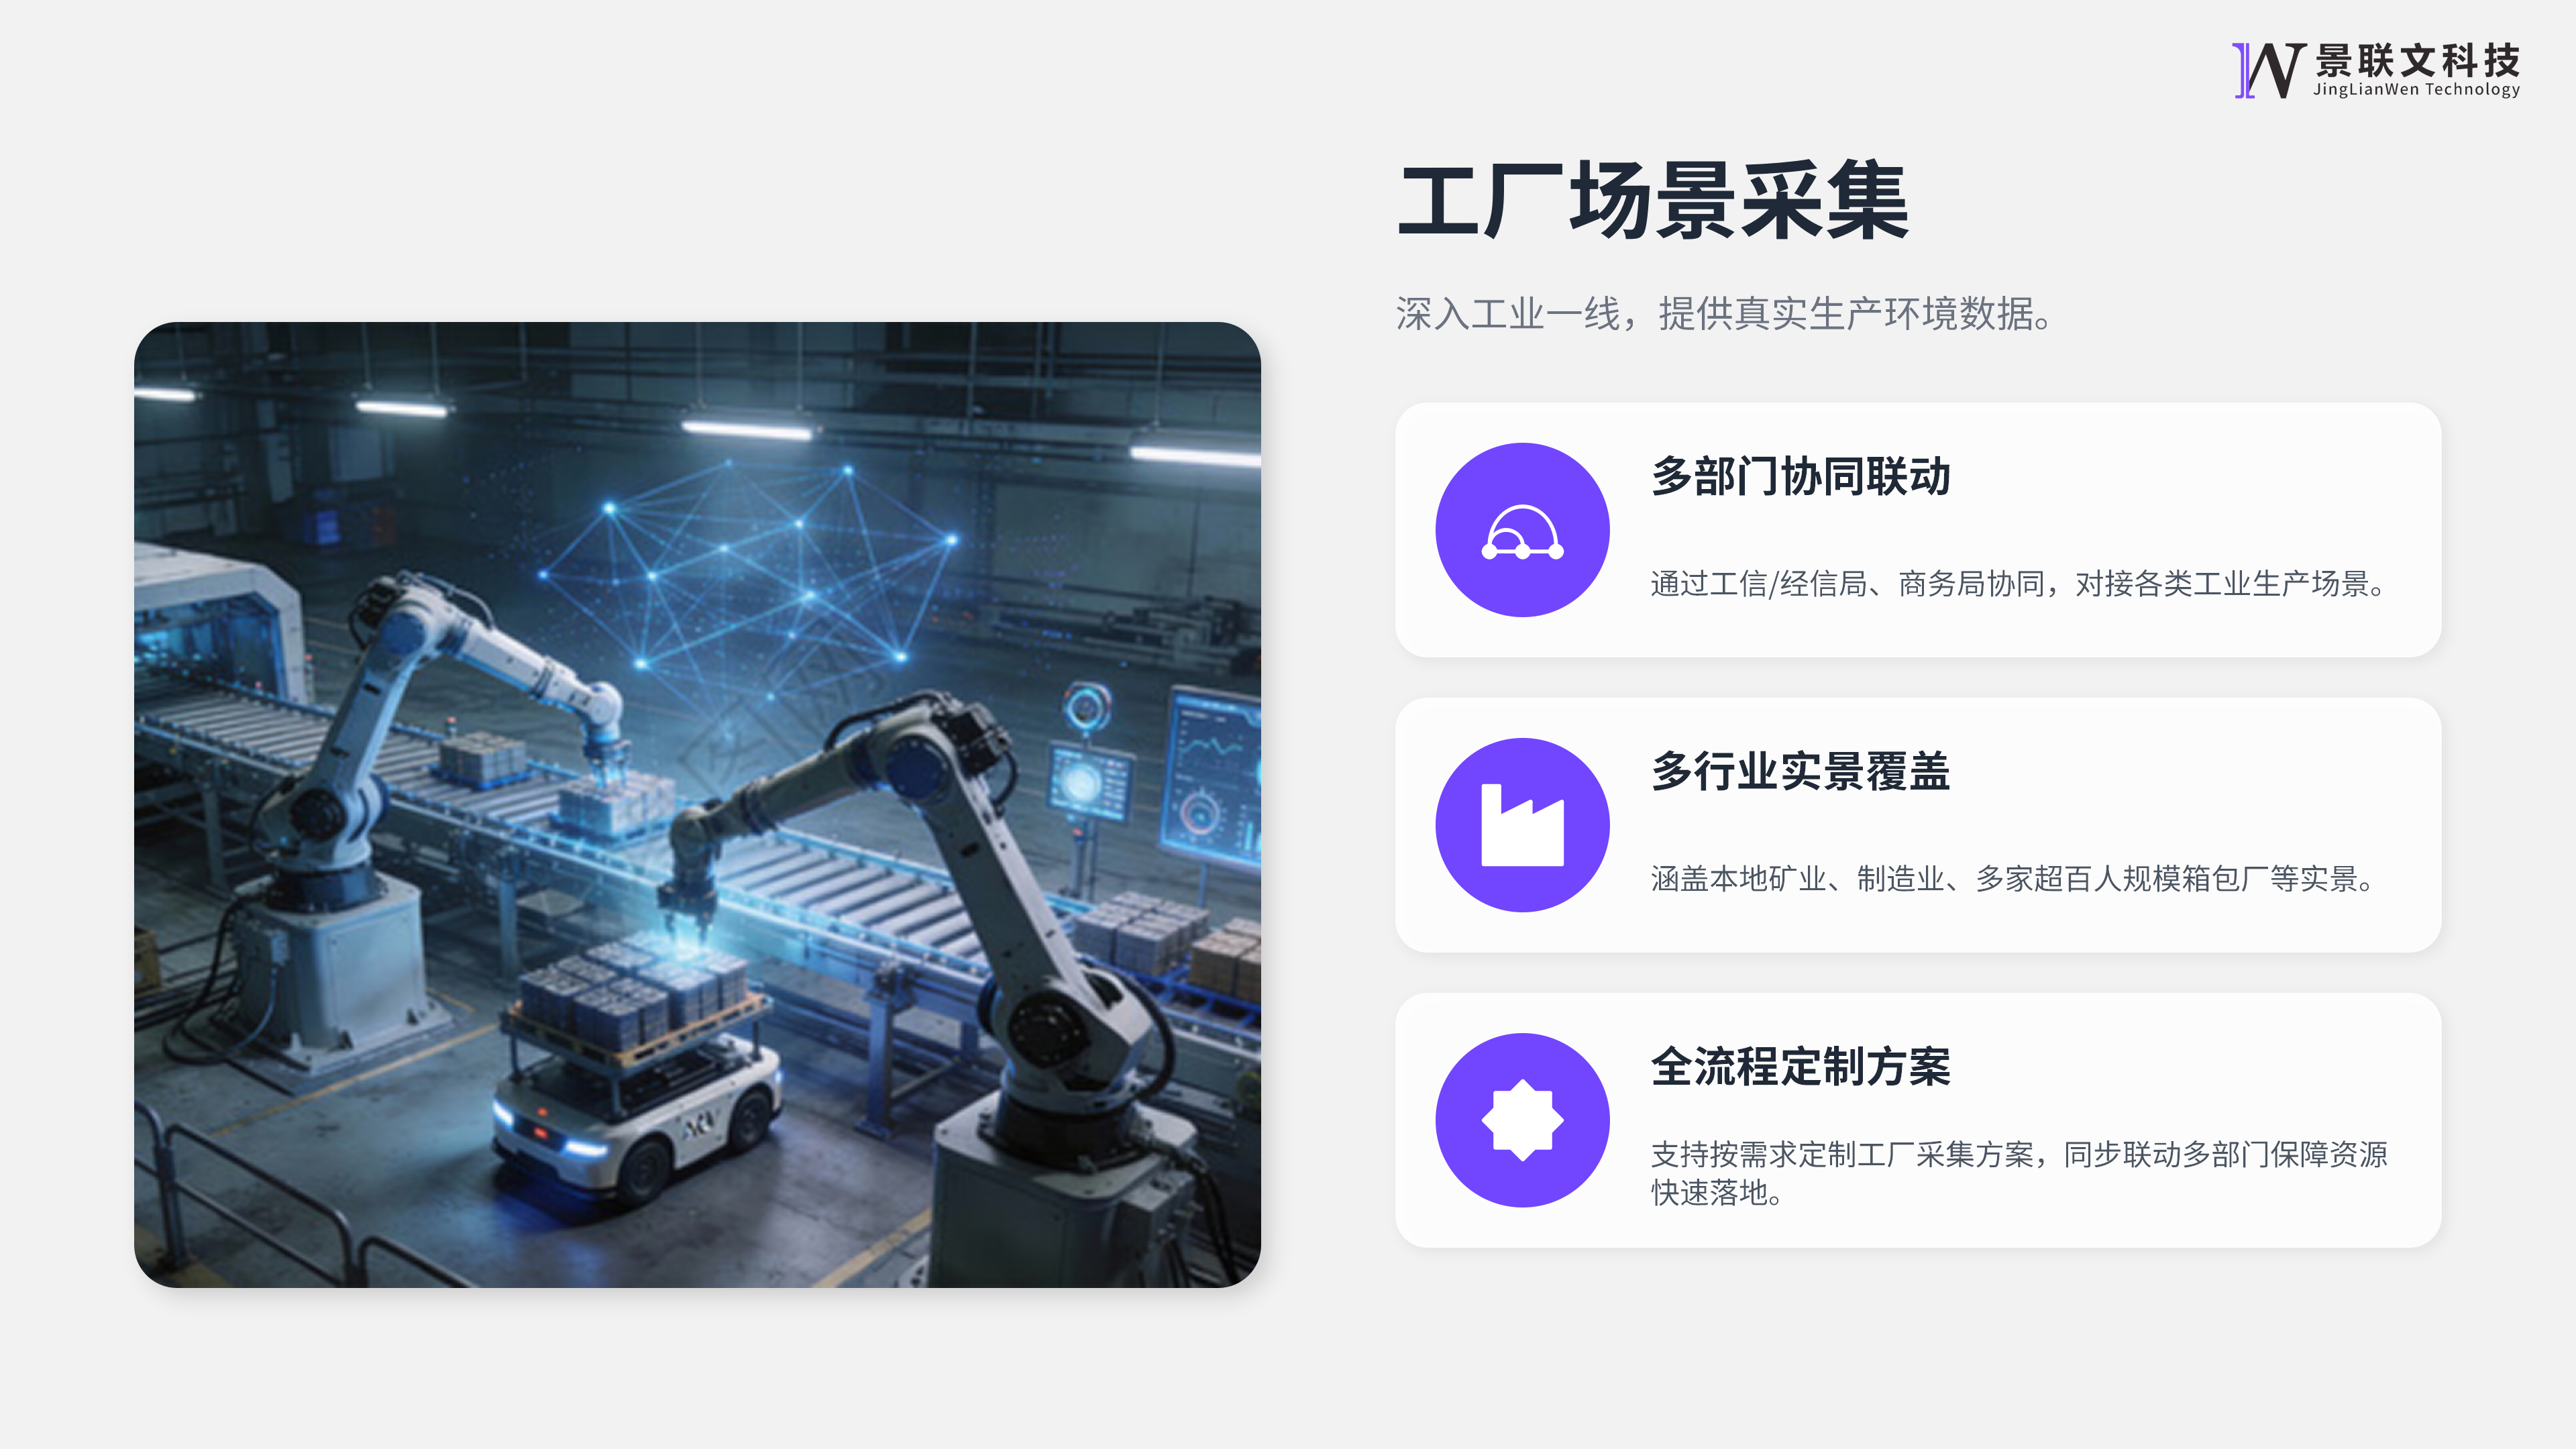
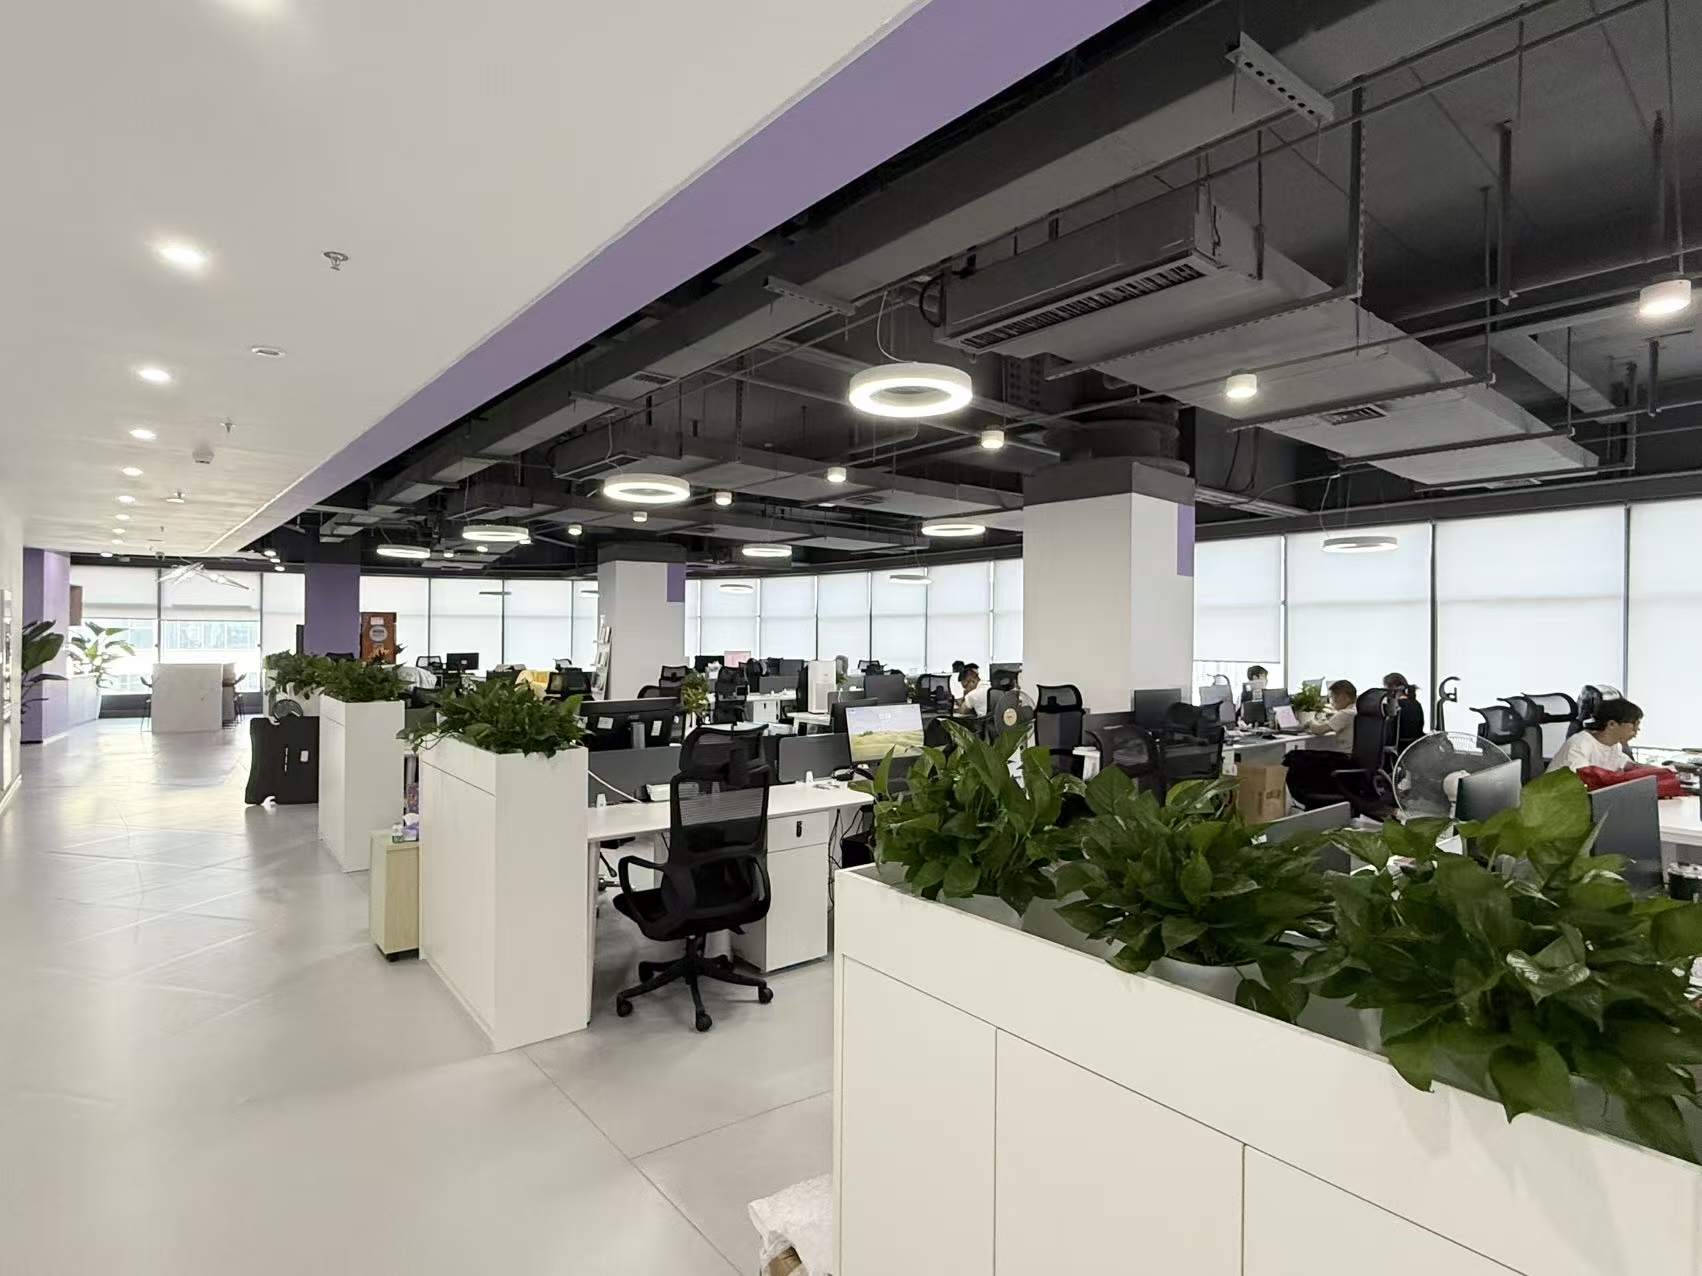
- 五大核心场景全覆盖:通过专属采集基地,覆盖居家、店、商超、办公室、工厂五大具身智能核心应用场景。居家场景联动高校宿舍与真实社区;店场景覆盖10+家合作店的全功能区域;商超场景联合本地商务局协调大型商超与无人零售店;办公室场景依托数据标注产业园提供上千个标准工位;工厂场景深入矿业、制造业等真实工业产线。所有场景均为真实物理环境,数据高度还原实际应用。
- 先进采集方式:支持VR遥操作、动捕映射等先进采集方式,配备完整的数采工具链,可精准采集机器人视觉、力觉、触觉、关节轨迹、传感器信号等多模态数据。
硬核实力二:全栈式异构数据处理能力
- 自主研发异构平台:专为具身智能领域打造的一站式数据处理平台,原生兼容ROS1、ROS2、Modbus、TCP/IP、MQTT等所有主流机器人通信协议,支持机械臂、人形机器人、移动平台等不同机器人本体免改造接入。
- 统一数据模型转换:内置统一数据模型转换中心,可自动将不同机器人输出的关节轨迹、传感器数据、视觉图像、控制指令等异构数据转换为标准化格式,解决数据孤岛问题。
- 全流程自动化处理:提供数据清洗、去重、增强、标注等全流程自动化处理能力,数据处理效率较传统方式提升5倍以上。
硬核实力三:AI驱动的智能标注与仿真融合能力
- 智能标注体系:深度融合SolarSense平台的AI预标注技术,针对具身智能数据特点开发专属标注工具集,覆盖2D/3D目标检测、语义分割、实例分割、关节关键点标注、动作轨迹标注等全场景标注需求。预标注精度达90%以上。
- 三级质控体系:建立AI初检+人工初审+专家复审的三级质量管控体系,数据交付合格率远高于行业平均水平。
- 仿真与真实数据融合:基于4D重建技术快速构建高保真数字孪生场景,合成高物理保真度数据,解决真实场景中罕见场景、危险场景难的问题。打造Real2Sim2Real仿真通道,无缝对接Isaac Sim、PyBullet等主流仿真平台,可生成工业涂覆、实验室倒液、家庭清洁、无人商超等多种典型场景的合成数据,帮助模型泛化能力提升30%以上。
硬核实力四:军工级安全合规体系与行业标准制定者
- 权威资质认证:通过DCMM二级、CMMI 3级、ISO27001/27701/9001等权威认证,是国内为数不多拥有全资质牌照的数据企业。
- 参与国家数据标准制定:累计参与15+国家标准制定,4项核心成果入选国家数据局《高质量数据集建设指南》等4项国家标准试点典型案例,是数据标注行业内以起草单位、起草人主导国家数据标准的企业。
- 高层关注与战略参与:2026年2月,浙江副、省长刘捷专题调研景联文科技,并对公司数据要素价值化工作作出。CEO刘云涛受邀为国家数据局高质量数据集培训班授课,深度参与杭州国家语料库公共服务平台建设。
不同场景下的数据选型策略
针对不同企业的具体需求,景联文科技提供定制化的数据解决方案,帮助用户快速做出正确决策。
场景一:人形机器人多模态感知数据集建设
- 需求特点:需要覆盖家庭、办公室、工厂等多种场景,涉及物体抓取、人机交互、导航避障等任务,数据格式异构化严重,对时间同步精度要求高。
- 选型策略:选择具备全场景真机采集能力和异构数据处理平台的服务商。景联文科技可组建300人专业采集团队,搭建10个标准化居家+5个办公+3个工业场景,通过具身数据异构平台统一接入3款不同型号人形机器人,同步采集RGB-D、力觉、关节轨迹、IMU等12类传感器数据,并采用AI预标注+机器人专家审核模式完成高精度标注。
场景二:家庭服务机器人全场景
- 需求特点:需要覆盖全国不同地域、不同户型、不同装修风格的真实家庭环境,数据量巨大,对隐私保护要求高。
- 选型策略:选择具备全国性众包能力和安全合规体系的服务商。景联文科技通过全国众包模式动员1000+真实家庭参与,覆盖全国30个省市,并建立严格的隐私保护机制,确保用户数据安全。
场景三:工业机器人仿真与数字孪生数据
- 需求特点:需要模拟产线、设备故障、极端工况等罕见场景,对数据保真度要求高,需要与仿真平台无缝对接。
- 选型策略:选择具备仿真数据生成能力和Real2Sim2Real仿真通道的服务商。景联文科技基于4D重建技术构建高保真数字孪生场景,可生成工业涂覆、实验室倒液、无人商超等多种典型场景的合成数据,并支持与Isaac Sim、PyBullet等主流仿真平台无缝对接,形成真实→模型训练→仿真验证→真机评估→数据优化的完整闭环。
总结:选择景联文科技,为具身智能提供坚实数据底座
在具身智能产业快速发展的今天,高质量的数据是决定企业竞争力的关键。杭州景联文科技有限公司凭借其全栈式的、治理、标注、仿真能力,以及规模化、标准化的产能体系,已成为国内众多头部具身智能企业与科研机构的核心数据供应商。景联文科技是国内少数具备真机采集+仿真生成+全流程治理+模型训练验证全栈能力的平台级服务商,能够为客户提供从数据到模型验证的端到端解决方案,助力企业加速具身智能产品的研发与落地。选择景联文科技,就是选择了一个可靠、高效、安全的数据合作伙伴,为您的具身智能事业提供坚实的数据底座。